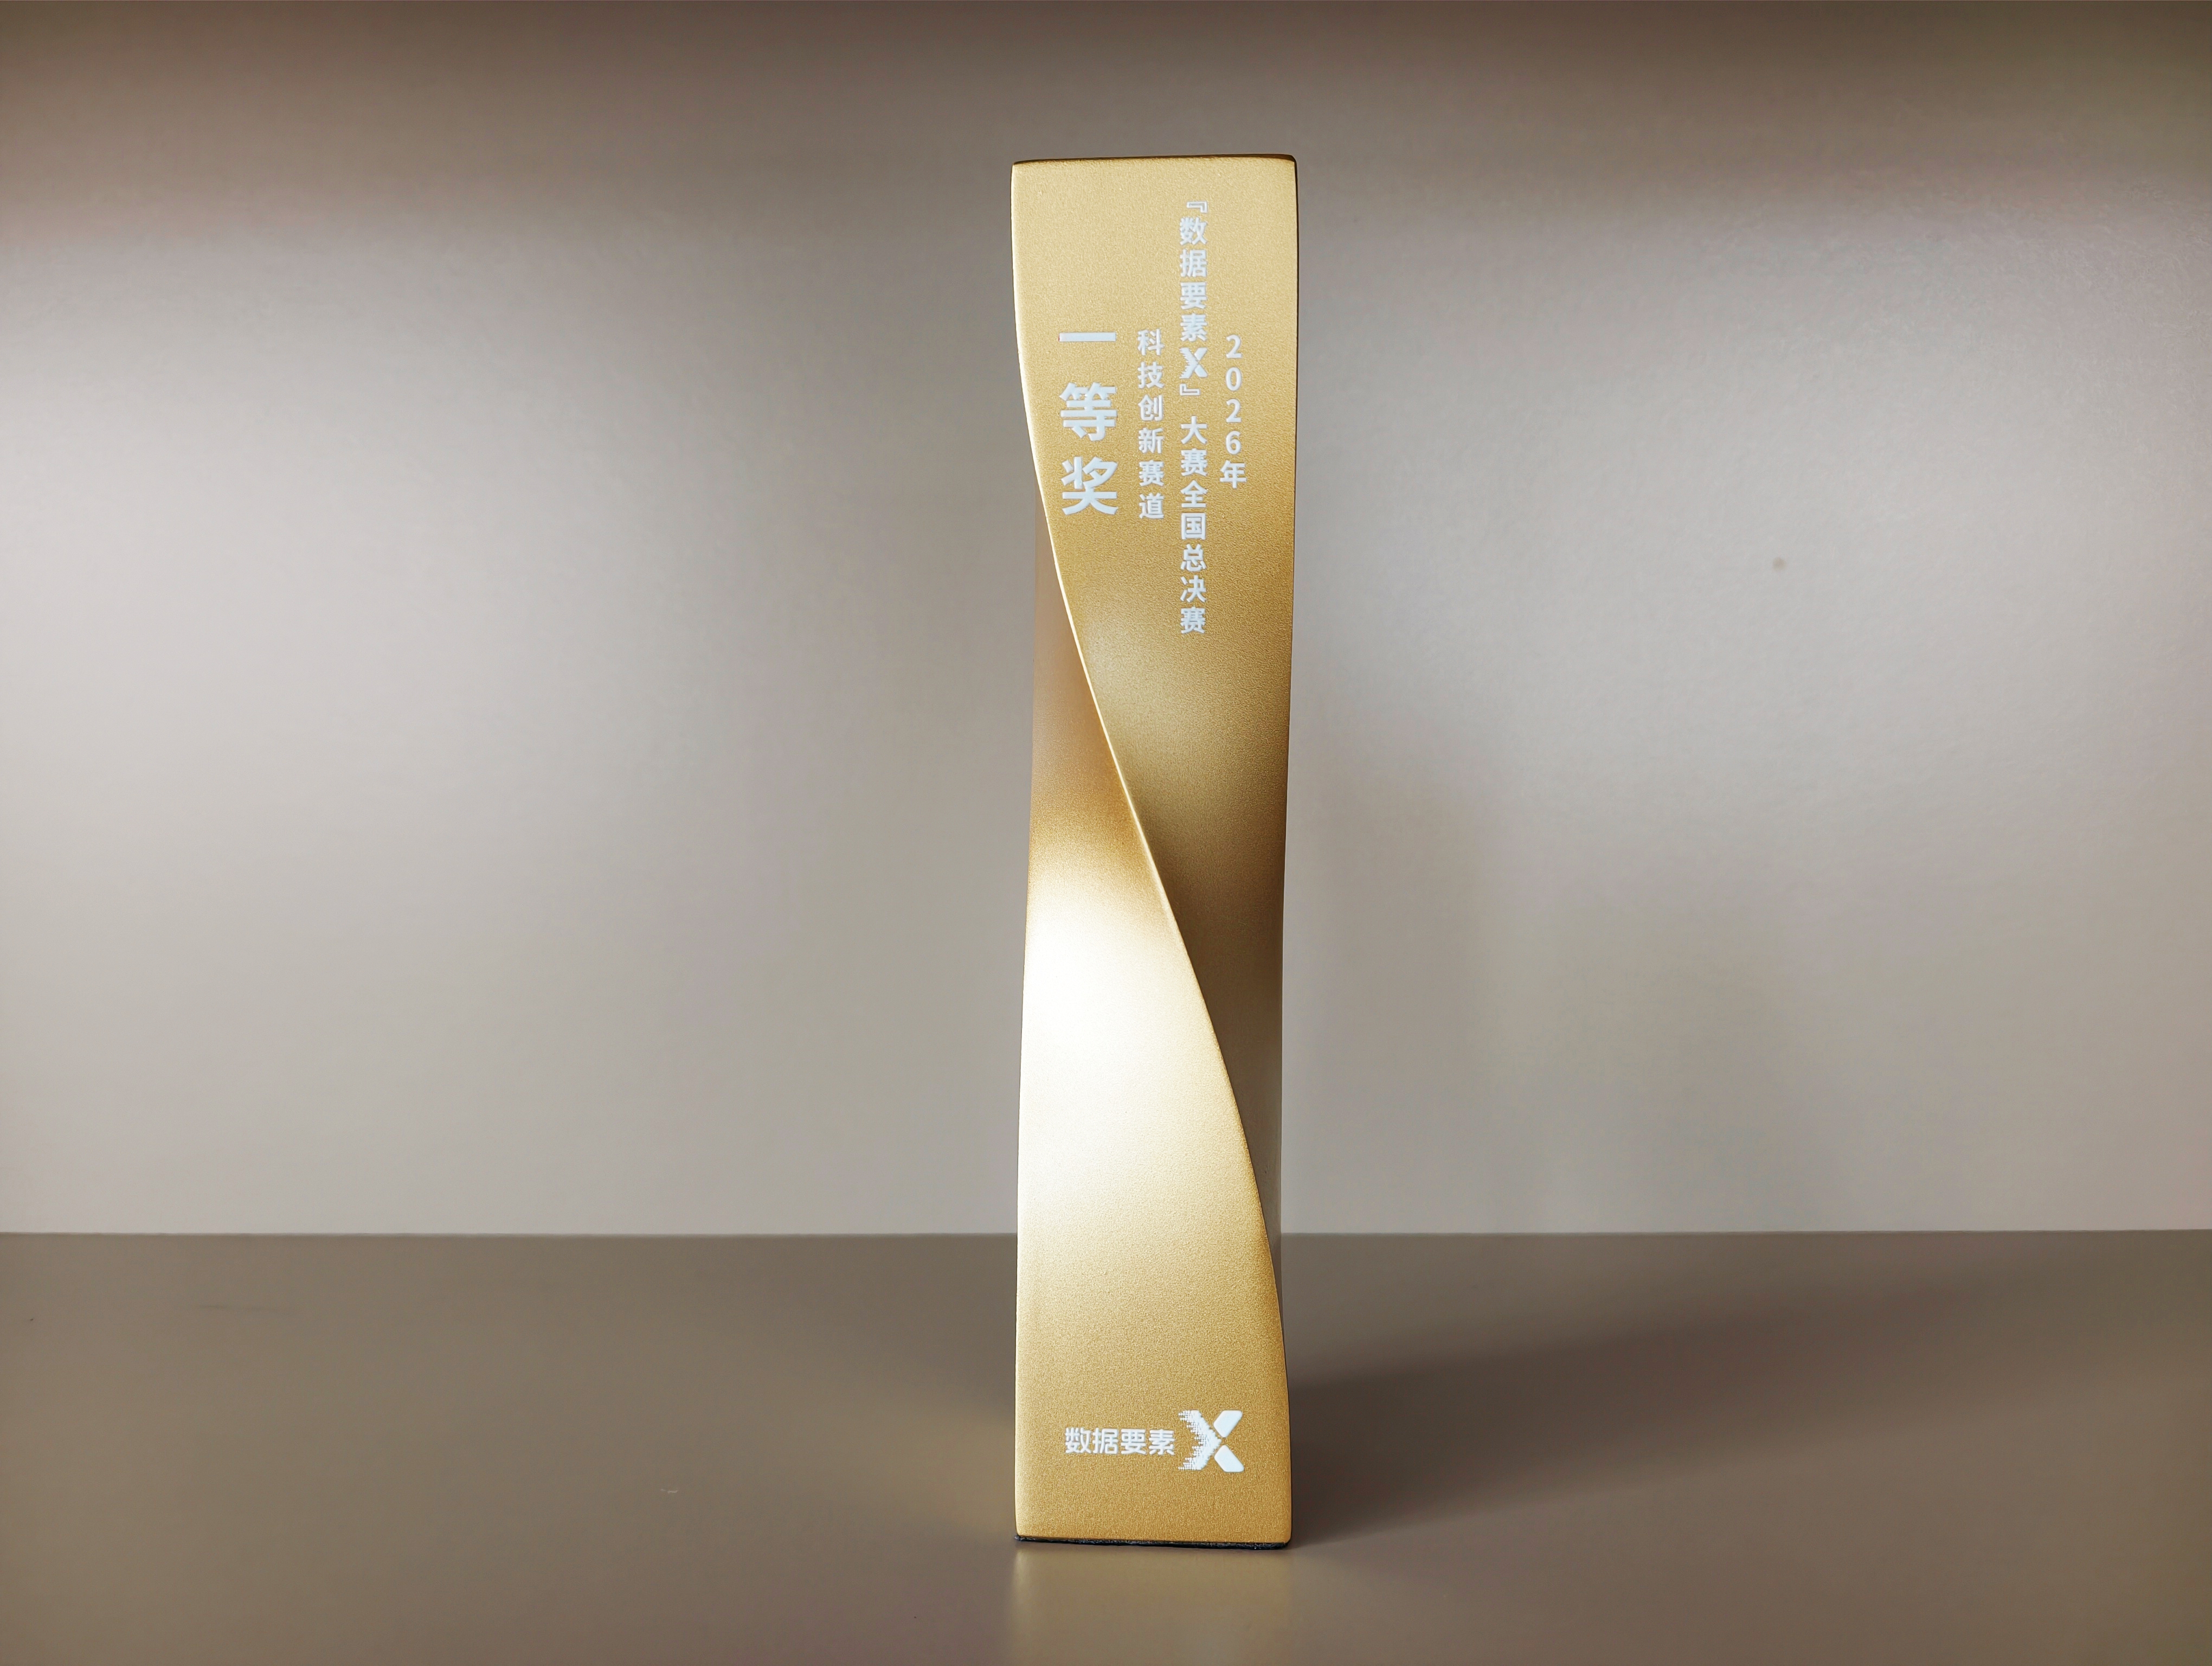
10月23日,2026年“数据要素×”大赛全国总决赛结果正式揭晓,上海天鹜科技有限公司凭借“高质量数据驱动的蛋白质设计物理AI智能体”项目,荣获全国总决赛⌈科技创新赛道⌋一等奖。这是继摘得“数据要素×”上海分赛一等奖后,天鹜科技再获殊荣,展现了公司以高质量数据赋能AI蛋白质设计、推动技术成果走向产业应用的创新实力。
蛋白质作为生命活动的“关键活性分子”,广泛应用于医药、食品、检测、农业、绿色能源和工业制造等领域,然而,天然蛋白质在稳定性、活性、亲和力等方面往往难以满足复杂产业需求,高性能蛋白质设计因此成为产业升级的共性刚需。传统蛋白质研发依赖经验判断和大规模筛选,面临研发周期长、试错成本高等挑战;AI为突破这一瓶颈提供了新路径,却也面临数据层面的挑战:现有公开数据以序列和结构为主,能够反映蛋白质实际功能及产业适应性的实验数据相对有限,且标准不一。如何让AI不仅认识蛋白质的序列与结构,还能准确预测其功能、指导实际研发,成为高质量数据发挥价值的关键。
针对这一挑战,天鹜科技自主构建了覆盖数据获取、合规记录、清洗治理到入库归档的全流程数据治理工具链,将复杂异构数据系统化治理为可直接用于模型训练的AI-Ready高质量数据。目前,已形成涵盖数百亿条蛋白质序列、约67亿条功能及环境标签的数据集,覆盖序列、结构、功能及抗体—抗原关系等多模态信息,相关数据集成果VenusPod曾入选国家高质量数据集典型案例,为AI蛋白质设计提供了经过权威认可的高质量数据底座。
在模型能力方面,高质量数据与算法创新的协同已取得具有国际竞争力的成果。在该数据集上预训练的Venus系列模型,形成覆盖蛋白质序列与结构建模、定向进化及酶挖掘的模型矩阵,支持零样本突变效应预测、小样本学习,以及有/无模板的功能酶挖掘,为不同研发需求提供模型支撑。其中,面向零样本突变预测的VenusREM,在哈佛医学院的ProteinGym榜单上长期位居榜首,并在哈佛大学最新发布的预印本PG-LLM评测中,成为蛋白突变预测行业对标权威参照。
为了进一步释放高质量数据的潜能,将模型能力转化为实际研发行动,天鹜科技将AI智能体与自动化实验相结合,打造AI驱动的干湿闭环蛋白质研发平台MatwingsVenus®(晓鹜®),平台以智能体作为统一任务入口,根据研发需求组合调用上述模型生成候选分子,并编排黑灯实验室完成表达、纯化和检测,贯通从计算设计到自动化实验验证的全流程,形成“设计—验证—迭代—升级”闭环,让数据所承载的蛋白质知识转化为可执行、可验证的研发方案。
依托高质量数据、Venus系列模型与智能体编排的自动化实验,蛋白质研发由“人工方案—逐批实验—再提方案”的串行模式,转为模型批量设计、自动化并行验证和实验结果迭代相结合的闭环模式。研发周期由传统的3至5年缩短至2至6个月,候选分子阳性率由不足5%提升至40%以上。目前依托该体系,天鹜科技已完成30余款蛋白质产品的设计与改造,并支撑PET降解酶、耐碱Protein A亲和层析填料、糖尿病友好型乳果糖等项目的产业化验证,推动高质量数据在绿色循环、生物医药和食品制造等场景中发挥实际价值。
此次荣获全国总决赛一等奖,是对天鹜科技数据应用创新与产业实践成果的肯定。未来,公司将持续提升高质量数据与AI技术的协同应用能力,面向真实产业需求加速蛋白质研发,让数据要素成为推动生命科学创新与生物制造发展的重要力量。